Desde hace un tiempo, los especialistas en tecnología elogian Kubernetes y sus beneficios para las empresas. La tecnología es abierta por defecto y, por eso, ofrece a las organizaciones la capacidad de llevar sus aplicaciones a containers en las situaciones más diversas – un recurso esencial para el número creciente de empresas que operan su infraestructura en la nube.
Pero no son solo los especialistas en tecnología quienes empiezan a ver el valor de Kubernetes: Gartner estima que el 70% de las organizaciones globales estarán ejecutando más de dos aplicaciones en containers para 2023. Con las aplicaciones corriendo en containers, las organizaciones empiezan a notar los beneficios de una configuración más sencilla, un deploy más ágil y un software más eficiente y confiable.
Sin embargo, es la capacidad única de Kubernetes para escalar y gestionar aplicaciones en containers lo que lo convierte en la mejor opción frente a las máquinas virtuales y otros softwares de aprovisionamiento para aumentar la eficiencia y agregar valor al negocio.
Por dentro de la solución
Kubernetes tiene un historial de entrega de potencial para los negocios. Un estudio reciente de VMware muestra que el 95% de los participantes observaron beneficios de Kubernetes, incluido un 56% que vio un mejor aprovechamiento de recursos, lo que significa menores costos de cómputo en nube privada o pública. Otro 33% de los encuestados dijo que Kubernetes ofrece costos más bajos de nube pública, porque es más ágil que otras alternativas disponibles en el mercado.
Las máquinas virtuales (VMs), por ejemplo, consumen muchos recursos del sistema, con copias del software que aprovisionan y un sistema operativo invitado. Además, las VMs son relativamente estáticas, por lo que es difícil moverlas entre servidores locales, nubes privadas o la nube pública.
En cambio, una aplicación de software en container se ejecuta sobre un sistema operativo externo, lo que elimina la cantidad de recursos de cómputo necesarios para ejecutar los varios sistemas operativos invitados. Un container también cuenta con herramientas centrales para gestionar cómo las aplicaciones usan los recursos del servidor, lo que, junto con el hecho de que ya no hay varios sistemas operativos que administrar, reduce la carga administrativa de la aplicación.
Las aplicaciones en containers con Kubernetes arrancan más rápido que las de una máquina virtual – milisegundos en lugar de minutos –, algo significativo en términos de engagement del usuario y eficiencia de tiempo. Además, su capacidad de escalar rápidamente le da a Kubernetes una ventaja competitiva, ya que los especialistas en Producto buscan software ágil que pueda responder a las demandas impredecibles del mercado.
Aun así, las implementaciones on-premises siguen teniendo su lugar en las organizaciones, que necesitan poder alternar entre la nube pública, la nube privada u on-premises, así como manejar picos de demanda. Las aplicaciones creadas con Kubernetes facilitan todo el proceso.
Kubernetes puede ayudar a orquestar containers en diversos tipos de entornos, incluido el hosting de software en la nube de un proveedor o incluso en un entorno híbrido. Esto permite que las empresas dejen de lado la carga de la complejidad de la implementación. Las funciones que conviene mantener cerradas por requisitos regulatorios pueden ejecutarse localmente o donde sea más práctico para el cliente. Gracias a Kubernetes, distintas partes de la aplicación pueden ejecutarse en servidores separados – local, nube privada, nube pública –; todo depende de lo que tenga más sentido para el usuario final.
Soporte a los 9 pilares del Site Reliability Engineering (SRE)
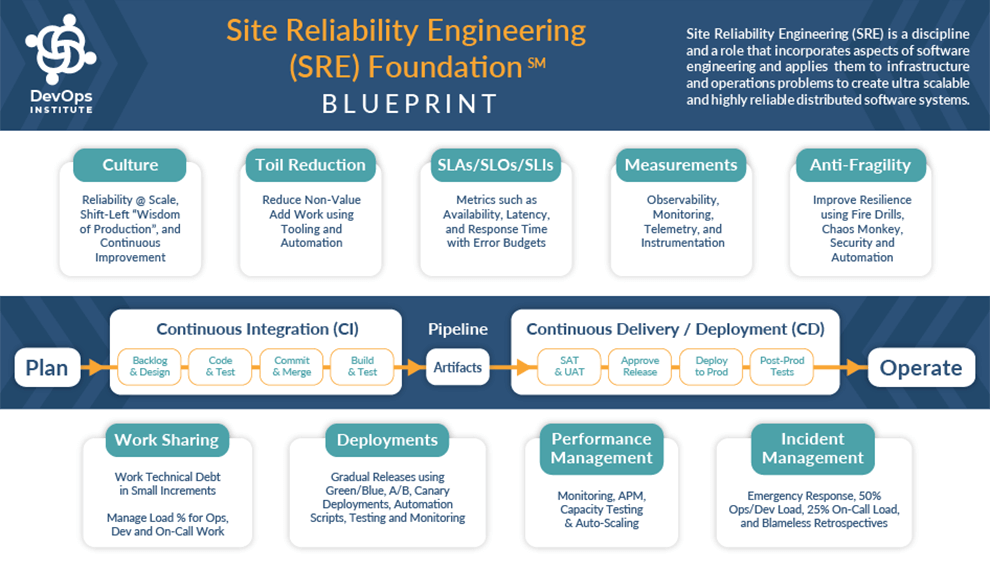
El SRE blueprint del DevOps Institute identifica 9 pilares en las buenas prácticas de Ingeniería de Productos.
Sus significados:
Liderazgo y cultura
Se refiere a los aspectos humanos de la búsqueda de servicios confiables a medida que se expanden, llevando la mentalidad de “sabiduría de producción” de Operaciones hacia el desarrollo y la búsqueda incesante de mejoras continuas. Esto se debe a que las prácticas de SRE fomentan una cultura de mejora continua de los servicios y sistemas que sostienen la producción, para garantizar que los servicios sigan siendo confiables a medida que escalan con el paso del tiempo. Los recursos de Kubernetes apoyan esta cultura de transformación y motivan a todo tipo de interesados.
Kubernetes ayuda a los líderes de negocio a impulsar a las organizaciones – cuyo éxito depende cada vez más de la capacidad de entregar servicios digitales y software rápidamente – a alcanzar un desempeño de siguiente nivel y a entregar nuevo software y funcionalidades innovadoras con mayor rapidez, además de posibilitar operaciones en varias nubes para lograr mayor agilidad y resiliencia.
Las infraestructuras de autoservicio habilitadas por containers y Kubernetes permiten que los equipos accedan a los recursos que necesitan cuando los necesitan. El resultado son equipos más productivos y felices, con menos impedimentos y mayor velocidad para implementar, colaborar, obtener feedback y restaurar servicios cuando sea necesario.
Reparto del trabajo
Se refiere a la práctica de trabajar la deuda técnica en pequeños incrementos y de gestionar porcentajes de carga de trabajo para Ops, Devs y trabajo de emergencia. Los SREs trabajan de forma deliberada y proactiva para educar e incorporar los puntos de vista y requisitos de operaciones al conocimiento y las actividades del equipo de desarrollo de servicios. La “sabiduría de producción” requiere un mejor diseño y comportamiento del sistema.
Para lograrlo, los SREs dedican una cantidad considerable de su tiempo (digamos, el 50%) a trabajo relacionado con operaciones, como la resolución de problemas, mientras que el otro 50% se destina a tareas de desarrollo, como la creación de nuevas funcionalidades, el dimensionamiento o la automatización. La capacidad de Kubernetes para levantar varias instancias de container con distintas políticas de escalado lo hace perfecto para trabajos y actividades de CI/CD en DevOps. Por ejemplo, una instancia de container puede incluir recursos de build y pruebas, además de aplicaciones, para crear clusters bajo demanda en un CI worker node con capacidad de containers.
Mediciones
Se refiere a las prácticas de uso de observabilidad, monitoreo, telemetría e instrumentación para medir el rendimiento de las aplicaciones. Las aplicaciones empresariales modernas requieren muchos microservicios distribuidos en varios nodos que se comunican entre sí. Un único punto de falla puede interrumpir todo el proceso; sin embargo, identificar el origen de la falla puede ser bastante difícil.
El monitoreo de Kubernetes es más sencillo cuando los containers exponen los datos de monitoreo. Las aplicaciones cloud native se construyen con métricas de reporte de salud para que la plataforma pueda gestionar los eventos de ciclo de vida si una instancia no está funcionando adecuadamente.
Producen (y dejan disponibles para exportación) datos de telemetría robustos para alertar a los operadores sobre problemas y permitirles tomar decisiones bien informadas.
Kubernetes soporta liveness probes que facilitan determinar el estado de una aplicación en un container. También vale recordar que Kubernetes se integra bien con herramientas de monitoreo como Prometheus y Grafana para crear un dashboard de monitoreo de Kubernetes.
SLOs y SLIs x Error Budgets
Se refiere a las prácticas de uso de Service Level Objectives (SLOs) y Service Level Indicators (SLIs) para medir disponibilidad, latencia y tiempo de respuesta, junto con error budgets para gestionar la confiabilidad de los servicios. Para los SLOs se recomienda el monitoreo a nivel de aplicación, por su relación directa con lo que es relevante para el cliente, en comparación con el monitoreo a nivel de sistema.
En entornos complejos, con servicios que dependen de la confiabilidad de muchos microservicios en containers, los SLOs y SLIs dependen de una comprensión clara de los elementos que contribuyen a las mediciones. Kubernetes ofrece una descripción consistente de los deploys de containers a gran escala, lo que permite una arquitectura estructurada para inyectar SLIs en todo tipo de plataformas de implementación.
Reducción del trabajo sin valor agregado
Se refiere a la práctica de reducir el trabajo sin valor agregado (toil) aplicando las herramientas adecuadas y la automatización. Kubernetes elimina gran parte del aprovisionamiento manual y de otras tareas de las operaciones de TI de una empresa. Además, los enfoques de orquestación unificada y automatizada que ofrece Kubernetes simplifican la gestión de varias nubes, permitiendo entregar más servicios con menos trabajo y menos errores.
La portabilidad de la gestión de la aplicación y de la orquestación entre plataformas de nube privada y pública, y entre versiones de sistema operativo, permite que desarrolladores y equipos DevOps creen aplicaciones y pipelines sin preocuparse por la infraestructura subyacente ni por los sistemas operativos que las aplicaciones necesitan para ejecutarse.
Gestión del rendimiento
Se refiere a las prácticas de monitoreo del rendimiento de aplicaciones, pruebas de capacidad y escalado automático. Kubernetes puede dimensionar fácilmente la infraestructura y las configuraciones de los worker nodes para responder a las demandas variables de distintos niveles de integración, así como para probar las demandas de carga de trabajo. Los recursos de infraestructura quedan agrupados y pueden consumirse y liberarse de forma elástica, lo que permite un dimensionamiento perfecto y un mayor aprovechamiento de los recursos.
Gestión de incidentes
Se refiere a las prácticas de respuesta a emergencias y de gestión de la carga de trabajo on-call de los SREs (por ejemplo, 25%). Kubernetes soporta este pilar de SRE con recursos para crear, validar y gestionar clusters desde una terminal single user. La visibilidad remota, las verificaciones de salud (health-checks) y las alertas de pods y clusters ayudan en el soporte on-call. Los SREs pueden actualizar el stack de Kubernetes junto con los distintos frameworks usados en la configuración y aplicar patches a los clusters.
Antifragilidad
Se refiere a las prácticas de mejora de la resiliencia mediante chaos engineering, seguridad y automatización. Las aplicaciones complejas que operan sobre infraestructuras distribuidas complejas pueden ser difíciles de mantener y proteger. Las herramientas cloud native, como Kubernetes, ofrecen más información sobre lo que está ocurriendo en una aplicación, lo que facilita identificar y corregir problemas y “apagar incendios”, sean cuales sean.
Kubernetes reinicia los pods que no están sanos. Los controles de orquestación mejorados que se aplican en la implementación y en las aplicaciones en containers se benefician de la consistencia inmutable y de mejores tiempos de respuesta. Los secrets objects de Kubernetes también ofrecen una forma segura de almacenar datos confidenciales. Kubernetes habilita servicios distribuidos modulares con mejor escalado y recuperación ante fallas.
Con información de Container Journal
Si estás evaluando una migración a Kubernetes — o ya migraste y todavía no ves lo que pasa dentro del cluster — el equipo de Elven puede ayudarte a montar la capa de observabilidad antes de que el primer incidente te pase la factura.
Observabilidad en Kubernetes
Un cluster oculta la falla por diseño: si un pod muere, otro se levanta en su lugar y el servicio sigue respondiendo. Eso es resiliencia, pero también es ceguera — sin métricas, logs y traces correlacionados, el equipo descubre el problema por el monto de la factura o por la queja del cliente, no por la alerta.
¿Quieres ver lo que pasa dentro de tu cluster? Habla con el equipo de Elven.