Una de las prácticas más recomendadas para los equipos dedicados al desarrollo de productos digitales que buscan alcanzar un 99,999% de disponibilidad es rastrear las versiones de aplicaciones y servicios y profundizar el conocimiento sobre las dependencias entre ellos. Esta práctica forma parte de la vieja y buena – aunque a menudo ignorada – Gestión de la Configuración.
Una Matriz de Resiliencia es una herramienta que muestra las aplicaciones y servicios de un producto determinado y conecta cada aplicación con sus dependencias. Pero no se queda ahí: también permite visualizar el nivel de impacto que sufre una aplicación cuando falla cada una de sus dependencias. Así, es posible identificar y corregir mucho más rápido lo que realmente le está causando un problema a un cliente.
El desafío del monitoreo en la nube
En un pasado no muy lejano, las empresas solían tener en sus entornos locales (on-premise) una cantidad limitada de recursos de infraestructura, con arquitecturas estáticas. Una vez configurado el monitoreo de esas aplicaciones, la idea era que no requirieran actualizaciones frecuentes.
Pero si avanzamos hasta el presente, muchas aplicaciones nativas de la nube se construyeron en 2020, mientras que las aplicaciones tradicionales terminaron siendo rediseñadas para aprovechar la nube. Pues bien: ahora que las arquitecturas se volvieron elásticas y distribuidas, el monitoreo se convirtió en un enorme desafío, porque hay que seguir blancos en movimiento. Algunas aplicaciones se ejecutan en implementaciones de tipo IaaS, o Infraestructura como Servicio; otras ya se ejecutan como componentes PaaS (de una Plataforma como Servicio) y un número creciente de aplicaciones se contrata como ofertas SaaS, de software como servicio.
¿Cómo podemos lidiar con esto?
Hay una frase famosa en el mundo Cloud/DevOps: “Trata a los servidores como ganado, no como mascotas”.
La imagen de abajo lo ilustra bien:
Al fin y al cabo, nadie puede arrear ganado llamando a cada vaca por su nombre. Sería una tarea humanamente imposible.
En cambio, si tienes que cuidar varias mascotas a la vez, puedes conocer e interactuar con cada una sin mayores problemas, ¿verdad? Eso es lo que los administradores de sistemas podían hacer con sus servidores en la era previa a la nube.
Sin embargo, si necesitas gestionar cientos de componentes que mantienen tu producto funcionando – igual que una persona arreando ganado, como en el ejemplo de arriba – tendrás que aprender técnicas nuevas, como el monitoreo y el rastreo distribuido. La buena noticia es que, con solo algunas configuraciones y convenciones, es posible mantener cientos o incluso miles de componentes más pequeños.
Como las transacciones ahora ocurren en varios lugares, el proceso de monitoreo debe ser capaz de rastrear y agregar cada etapa. La gestión de logs también cambió mucho, ya que muchas máquinas y contenedores tienen ciclos de vida cortos. El proceso de logging estándar ahora implica logs centralizados con stacks como ELK o Graylog, entre otros.
La combinación de estas nuevas herramientas y procesos suele llamarse “Observability” (“Observabilidad”), porque representa mucho más que un simple monitoreo. Hablaremos mucho sobre el tema en este blog.
Productos, aplicaciones y servicios
Pero antes de avanzar en el tema del monitoreo, es fundamental alinear la semántica y explicar cómo definimos cada uno de los elementos que componen su estructura.
Producto es algo que una empresa ofrece a sus clientes o quizás a un grupo interno de empleados. Tiene un significado comercial y por lo general está compuesto por varias aplicaciones y servicios.
Aplicación es algo que la empresa desarrolla internamente (tal vez con la ayuda de socios o contratistas) para generar valor dentro del contexto de un Producto. Normalmente mejora con el tiempo y recibe actualizaciones frecuentes mediante corrección de bugs e implementación de nuevas funcionalidades. Las Aplicaciones generalmente dependen de los Servicios para funcionar.
Servicio es algo que la empresa usa para construir Aplicaciones. Puede ser un servicio de infraestructura, como una base de datos, o algo más sofisticado, como una API de Precios.
Aunque los servidores, contenedores y otros componentes técnicos cambian con mucha frecuencia en entornos de nube, los productos, aplicaciones y servicios cambian mucho menos. Además, son mucho más relevantes para los clientes, por lo que tiene sentido monitorearlos a ellos en lugar de las piezas móviles subyacentes.
Las buenas prácticas de ITIL recomiendan usar una Configuration Management Database (CMDB) para gestionar servidores y otros tipos de dispositivos, que generalmente están vinculados a entornos legados on-premise. La mayor parte de las ideas detrás de esas prácticas sigue siendo relevante en entornos de nube cuando hay un cambio de mentalidad.
Al fin y al cabo, es posible gestionar, como entornos, Aplicaciones, Servicios y otras entidades relevantes en un Catálogo de Aplicaciones y Servicios. Y gestionar el ciclo de vida de la aplicación se vuelve mucho más fácil con información de calidad disponible en el Catálogo.
Verificaciones de integridad
Cuando el foco está en componentes de alto nivel, como las Aplicaciones, hacen falta rutinas eficaces para verificar que todo funcione como debería. Aquí podemos hacer una analogía con un avión, donde evidentemente queremos tener la certeza de que todo funciona en perfectas condiciones, filtrando todo el ruido alrededor.
Esto se hace mediante verificaciones de integridad de la aplicación (conocidas como “health-checks”). En pocas palabras, ejecutar un health-check es una forma de verificar si una aplicación está funcionando bien y sin problemas. Las aplicaciones deben construirse con el concepto de Observability en mente, lo que facilita descubrir si hay que hacer algo o no.
Veamos un ejemplo práctico. Cuando se ejecuta una verificación de integridad, una aplicación debe comunicarse con cada uno de sus servicios de la misma forma en que lo hace todo el tiempo; si necesita datos de una base de datos, debe intentar obtener datos de esa base de datos. Si necesita enviar correos a clientes, debe intentar enviar un correo simple a una dirección real. De esta forma, si enfrentamos cualquier tipo de problema, el health-check nos dirá de inmediato en qué verificación ocurrió la falla.
Cómo se ve la matriz dentro de la plataforma
En Elven Platform, esta clasificación deja de ser un documento y se convierte en configuración: cada componente crítico de la matriz recibe sus propios monitores, su umbral de alerta y su ruta de guardia. Lo que estaba en el eje más crítico de la matriz es lo que despierta a alguien a las tres de la mañana; el resto espera al horario laboral.
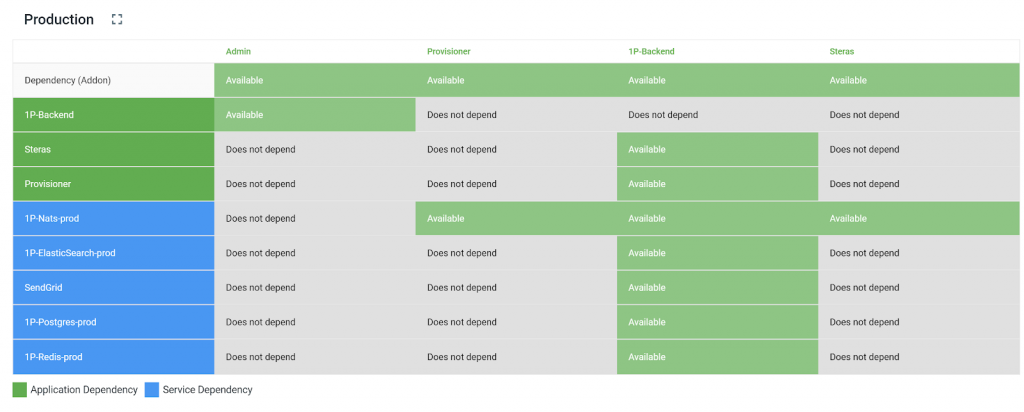
En este ejemplo, tenemos 4 aplicaciones, en columnas:
Admin
Provisionador
1P-Backend
Steras
En cada fila de la Matriz, podemos ver las dependencias de Aplicación y de Servicio. Tomemos la aplicación 1P-Backend para describir sus dependencias:
1P-Nats-prod: servicio de infraestructura
1P-Elasticsearch-prod: servicio de infraestructura
Sendgrid: servicio externo
1P-Postgres-prod: servicio de infraestructura
1P-Redis-prod: servicio de infraestructura
Algo interesante de la Matriz es que facilita verificar qué puede estar causando un problema específico en el sistema. Así, cuando ocurre un incidente, podemos verificar al instante si alguna dependencia también está fallando y, con eso, agilizar la resolución de problemas, todo en tiempo real y en cuestión de segundos.
En cada celda de la Matriz de Resiliencia tenemos 1 de 3 opciones, según el impacto que una dependencia causa en las aplicaciones asociadas a ella:
Disponible: cuando la aplicación tolera fallas en la dependencia sin ningún impacto relevante para sus clientes
Degradado: cuando la aplicación todavía puede operar parcialmente, pero pierde parte de su comportamiento habitual. Ejemplo: cuando YouTube deja de renderizar miniaturas, pero sigue reproduciendo videos
No disponible: cuando la aplicación no puede cumplir su propósito
Hay algunas técnicas que las aplicaciones pueden usar durante las fallas, como el patrón Circuit Breaker. Sin embargo, cómo diseñar un sistema para manejar fallas y construir aplicaciones resilientes son temas para otros artículos que abordaremos en este blog más adelante. ¡Así que suscríbete a nuestro newsletter y mantente atento! 🙂
¿Y cómo optimizar las verificaciones de integridad?
Al conocer las dependencias, es posible mejorar las verificaciones de integridad para validarlas adecuadamente. Como cada servicio se monitorea de forma independiente, en el health-check de OnePlatform es posible validar que cada aplicación use con éxito la dependencia correspondiente.
Un ejemplo sería hacer una consulta en la base de datos o intentar escribir y leer en un servicio de caché. Al hacerlo, es posible tener la certeza de que las credenciales y la red también funcionan sin problemas.
Si tomamos nuevamente como ejemplo la aplicación 1P-Backend, un payload de verificación de integridad se vería así:
{
   "1P-Nats-prod" : "OK",
   "1P-Elasticsearch-prod": "OK",
   "Sendgrid" : "ERROR",
   "1P-Postgres-prod" : "OK",
   "1P-Redis-prod" : "OK"
}
Tenemos varios atributos clave-valor, uno por cada dependencia, y valores simples como “OK” y “ERROR” para describir si la aplicación puede usar la dependencia o no. En este ejemplo, la única dependencia con falla es Sendgrid.
Eso no quiere decir que Sendgrid esté caído para todos; puede ser solo un problema con la cuenta. Lo relevante aquí es que los correos transaccionales probablemente no se están enviando, ya que la dependencia que se encarga de eso está devolviendo errores a la aplicación.
Este enfoque de verificación de integridad se recomienda para todas las aplicaciones, por su simplicidad y por lo que aporta al diagnóstico y a la resolución de problemas.
La Matriz de Resiliencia en una organización
Aunque es relativamente fácil entender una Matriz con varias aplicaciones y servicios, la tarea puede volverse mucho más compleja cuando tenemos decenas o incluso cientos de apps y servicios en una misma matriz.
Sin embargo, los equipos de producto normalmente no gestionan tantas aplicaciones y servicios. Por lo general, para un Producto determinado, necesitarás solo una o 2 matrices para mostrarlo por completo. En una organización, en cambio, puedes tener muchas matrices si tienes muchos equipos de producto, pero cada matriz estará enfocada en un dominio específico.
Si quieres aplicar las técnicas descritas en este post con tu equipo, ¡no dudes en ponerte en contacto con nosotros!
De la matriz a la operación
La matriz solo vale el tiempo de construirla si se convierte en configuración: los componentes clasificados como críticos necesitan un monitoreo más fino, alertas con su propia ruta de guardia y un SLO declarado. Sin esa traducción, el ejercicio se queda en el slide y la operación sigue tratando todo con la misma prioridad.
¿Quieres convertir tu matriz de criticidad en alertas de verdad? Habla con el equipo de Elven.